Monitor
Dashboard · Infraestructura
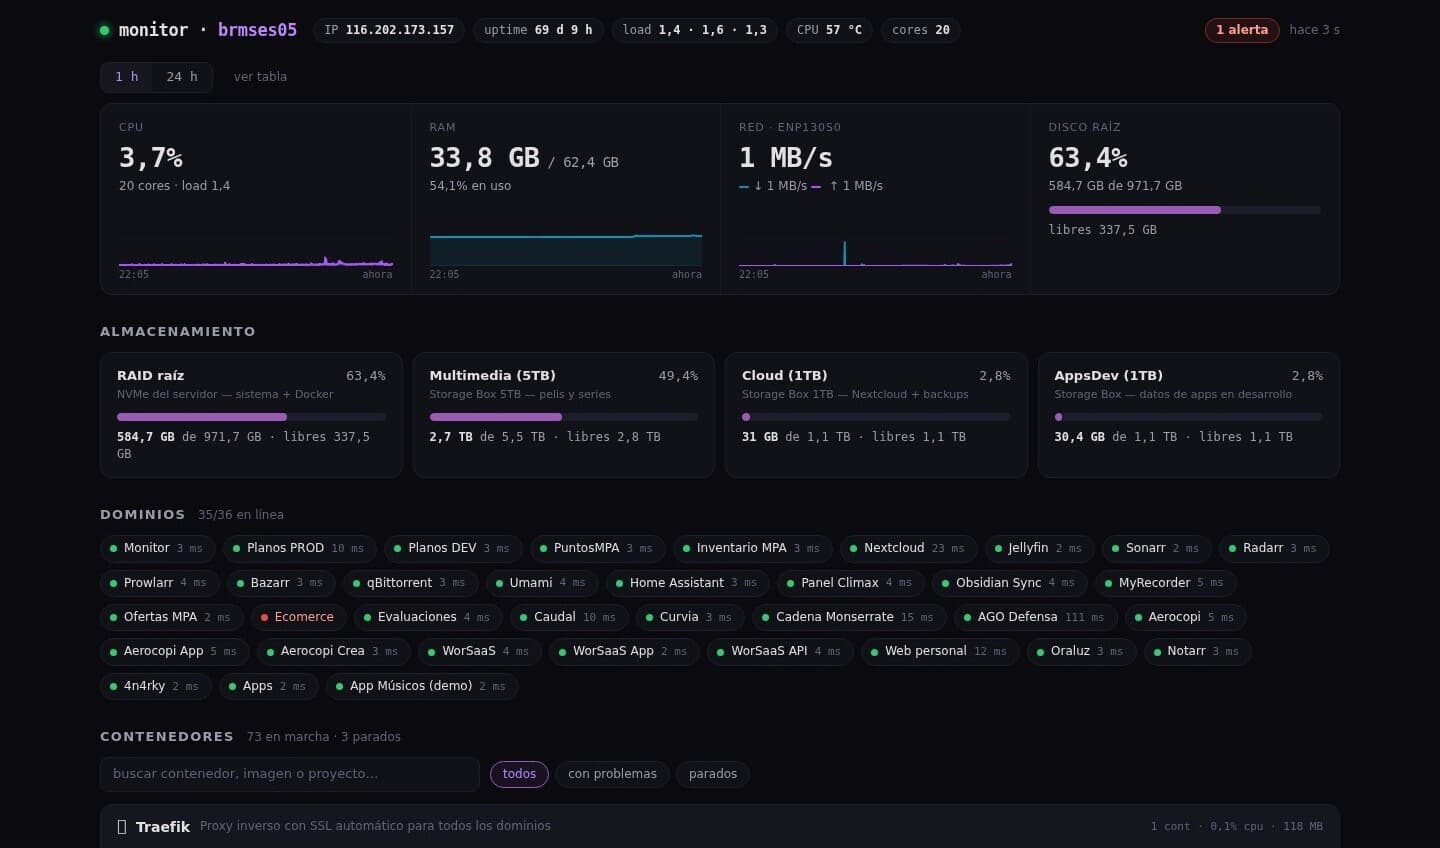
Panel de monitorización de servidor escrito desde cero sin una sola dependencia npm: 72 contenedores, 36 dominios y 3 storage boxes vigilados en tiempo real.
Sobre el proyecto
Alternativa casera a Grafana/Netdata para vigilar un servidor dedicado completo: métricas de host con sparklines (CPU, RAM, red, disco, temperatura), 72 contenedores Docker agrupados por proyecto, salud HTTPS de 36 dominios con caducidad de certificados y montajes CIFS verificados por statfs. La decisión de diseño clave: cero dependencias — el backend es Node 20 puro (~570 líneas) y el frontend vanilla JS. El acceso a Docker pasa por un socket-proxy de solo lectura: el panel jamás puede tocar un contenedor. Y su principio rector: un panel verde con datos viejos es el peor fallo posible, así que si la fuente de datos deja de responder, lo dice a gritos.
Stack tecnológico
Funcionalidades clave
- Backend Node sin ninguna dependencia externa: recolector, API y servidor de estáticos en ~570 líneas
- Sparklines de CPU/RAM/red/disco/temperatura con series de 1h a 5s y 24h a 2min en RAM
- 72 contenedores vigilados vía socket-proxy de solo lectura — imposible tocar contenedores desde el panel
- Salud HTTPS de 36 dominios: latencia y días hasta caducidad del certificado
- Detección de storage CIFS desmontado por magic number de statfs
- Alertas derivadas: unhealthy, crash-loop, disco lleno, certificado a punto de caducar
- Alerta crítica de «datos congelados» si la API de Docker deja de responder
- Catálogo declarativo: añadir un proyecto o dominio es editar un JSON
Desafíos técnicos
Leer métricas del host desde un contenedor aislado: /proc del PID 1 para la red y statfs para los discos
Sobrevivir a montajes CIFS colgados sin congelar el loop de muestreo: timeouts y pool de hilos ampliado
Que un fallo del recolector nunca parezca un servidor sano: alertas explícitas de datos congelados
¿Quieres algo similar para tu negocio?
Solicitar presupuesto